MATSim実践編――渋滞をシミュレーションしてみる:リタイア直前エンジニアの社会人大学漂流記(8-2)(3/4 ページ)
今回のMATSim(マルチエージェントシミュレーション)実践編では、交通渋滞のシミュレーションをやってみたいと思います。MATSimにおいて、渋滞の実現に使われているメカニズム「QSim」についても解説します。
シミュレーションをやってみよう
では、シミュレーションをやってみましょう。シミュレーション環境は、できるだけ簡単にするために、以下のようにしてみました。

この実験では、N1とN2からそれぞれ車両を流入させ、N3で合流させた後、N4へ向かわせます。
W1とW2の需要は、それぞれ400 veh/hとします。ここで veh/h(vehicles per hour)は「1時間あたりの車両数」を意味します。従って、W1とW2からは、それぞれ1時間に400台、合計では800 veh/hの車両がN3へ向かって流入することになります。
各LinkのLengthは1000m、Free Speedは15m/sとします。LengthはLinkの長さ、Free Speedは渋滞がない場合に車両が走行できる自由走行速度です。従って、混雑がなければ、1つのLinkを通過するのに必要な時間は、
1000 ÷ 15 ≒ 66.7秒
となります。これが、このLinkのfree-flow travel timeです。
一方、N3からN4へ向かうW3の容量は600 veh/hとします。これは、W3から1時間に最大600台までしか車両を流出させることができない、という意味です。
ところが、W1とW2からN3へ流入する車両は合計800 veh/hの需要があります。
つまり、
流入800 veh/h > 流出可能量600 veh/h
となります。
このため、N3付近では車両を全てW3へ送り出すことができず、余った車両がキューとして蓄積していくはずです。単純に考えれば、
800 - 600 = 200 veh/h
の割合で待ち車両が増えていくことになります。
今回の実験では、この非常に単純なネットワークを使って、flow capacityによる渋滞の発生、FIFOによる車両の流出、そして流入停止後のキューの解消が、想定通りに再現されるかを確認していきます。
では、以下の図のアルゴリズムに従って、プログラムを書いていきます。

こちらに、Goプログラム(qsim_go_minimal.go)を添付しておきます。
このプログラムでは、W1とW2からそれぞれ400 veh/hの需要を発生させます。これは、各道路から9秒に1台の割合で車両を送り出す設定です。
W1とW2の容量はそれぞれ600 veh/hなので、単独では渋滞しません。しかしN3で合流すると、W3には合計800 veh/hが流れ込もうとします。一方、W3の容量は600 veh/h しかありません。
つまり、400 + 400 = 800 veh/h > 600 veh/hとなり、W3内部、とくに出口側に待ち行列が形成されていきます。さらに渋滞が続いてW1やW2まで一杯になると、N1・N2から新しい車両を入れられなくなり、spillbackが発生しますので、今回は需要を30分間だけ発生させることにして、W1から200台、W2から200台、合計400台のエージェントを使って、この渋滞の発生と上流への波及を確認します。
つまり、このプログラムで期待される問題(?)は、800 - 600 = 200 veh/hの割合で待ち車両が増えていくか ―― 1時間あたり200台の割合で、W3の出口待ち車両が増えていく ―― という現象が表れるかどうか、です。

プログラムの実行結果は以下の通りです。

[A]は、シミュレーションの条件を示しています。
- Agents : 400
「シミュレーションに登場するエージェント(車両)の総数は400台」 - Demand per approach : 400 veh/h
「W1、W2それぞれから、1時間あたり400台の需要が発生する」
つまり、各方向から約9秒に1台ずつ車両が出発します。 - Combined demand : 800 veh/h
「W1とW2を合わせると、N3には1時間あたり800台が流れ込もうとする」 - W3 flow capacity : 600 veh/h
「W3が1時間あたりに通過させられる車両数の上限は600台」
従って、800 veh/hの需要に対して200 veh/h分が処理しきれず、渋滞が発生します。 - Free-flow time/way : 67 s
「渋滞がない場合、1本のLinkを通過するのに約67秒かかる」
Length 1000m、Free Speed 15m/sなので、1000÷15≒66.7秒です。 - Storage/way : 133 vehicles
「1本のLinkの中に同時に存在できる車両数の上限は133台」
これを超えると、そのLinkには新しい車両が入れなくなります。
[B]は、各時刻の行に出てくる項目を示しています。
- t=300s
「シミュレーション開始から300秒後の状態」 - W1=8 / W2=8 / W3=24
「その時点で、それぞれのLink内に存在している車両数」 - W3-ready=10
「W3の中で、既にfree-flow travel timeを経過し、出口から出られる状態になって待っている車両数」――要するに、W3出口の待ち行列に相当する台数です。 - in-network=40
「W1、W2、W3を合わせて、現在ネットワーク内に存在している車両数」 - arrived=28
「N4まで到着済みの累積車両数」
[C]は、シミュレーション全体の集計結果を示しています。
- arrived : 400 / 400
「400台全てが最終的に目的地N4へ到着した」 - peak W3 occupancy : 112 vehicles
「W3内に存在した車両数の最大値は112台」 - peak network load : 123 vehicles
「ネットワーク全体に同時に存在した車両数の最大値は123台」 - mean travel time : 435.5 s
「出発してから到着するまでの平均所要時間は435.5秒」 - CSV : qsim_result.csv
「時刻ごとの結果を qsim_result.csv というCSVファイルに保存した」
では、最後にこの結果の概要を図で示しましょう。

この図では、W1とW2からの流入が続く0~1800秒の間、W3の出口待ち車両がほぼ一直線に増加しています。
1800秒で車両の流入を止めると、その後はW3から車両が順次流出し、待ち行列は減少して、約2700秒で解消します。
流入800 veh/hに対して流出容量は600 veh/hなので、超過需要は200 veh/hです。これが30分続けば、単純計算では200×0.5=100台の滞留が生じることになります。1800秒時点のW3出口待ちは94台で、この理論値に近い結果になっています。
つまり、この実験では、流入量が流出容量を上回るとキューが増え、流入を止めるとそのキューが順次解消していくという、QSimの基本的な渋滞挙動を確認できたことになります(ちなみに、1秒単位の結果が“qsim_result.csv”というファイルで作成されていますので、必要に応じて確認してください)。
「研究とは、愛である」
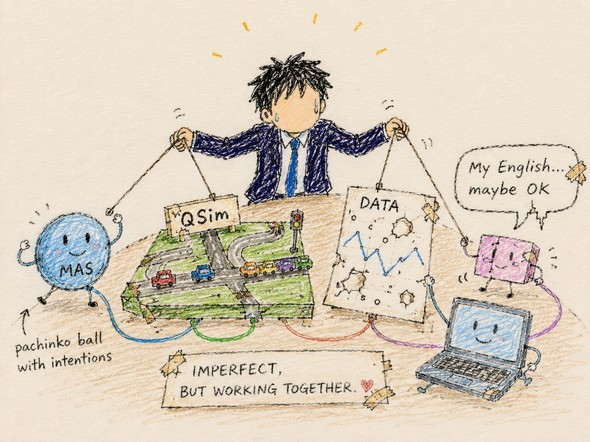
結局のところ、私はこの3年間、「英語はデタラメでも使え」「データは信用しすぎるな」「MASのエージェントが本物の人間だと思うな」「でもシミュレーションは使い倒せ」という、かなりムチャな世界で研究をしてきたことになります。
しかも、その中で一番まともそうに見えたQSimですら、『車の細かい動きは、もう見ないことにしよう』という、なかなか豪快な開き直りの上に成立しています。車は1台ずつ残す。でも、「何メートル地点にいるか」までは追わない。渋滞は表現する。でも、ブレーキの踏み方までは知らない。
要するに、
―― 分からないものは、分からないままにして、必要なところだけ計算する。
ということです。
―― なんだ、それなら、私の英語と同じじゃないか。
文法は怪しい。発音も怪しい。でも、相手に意味が通れば、その場はなんとかなる。
現実データも同じです。
目的によって、見えるものと見えないものがあります。でも、その限界を承知して使えば、そこから分かることはあります。
有吉先生の「意思を持ったパチンコ玉」も、結局そこにあります。
パチンコ玉に本物の意思などありません。しかし、そこに「意思らしきもの」を組み込み、十分な数を転がしていると、時々、人間社会っぽい何かが見えてくる。
そして、64bit OSと大容量メモリのおかげで、そのうさんくさい道具を、私のような人間でも自宅のPCで何万人分も動かせるようになったことは、技術の進歩というより、
―― メモリが増えたから、パチンコ玉をたくさん転がせるようになった
くらいの話なのかもしれません。
多分、MASというのは、そういう、かなり胡散臭くて、しかし妙に役に立つ道具なのです。
そして、これはMASだけの話ではありません。私の日常そのものが、
―― 不完全なもの同士を、うまくだましながら働かせる
を、延々と続けているだけなのかもしれません。
……と、ここまで書いて、ちょっと考えました。
これは「私の日常」どころの話ではなく、
―― 「研究」というもの自体が、不完全なデータ、不完全なモデル、不完全な理論、そして不完全な研究者(私)を、なんとか組み合わせて動かす営みなのではないか
と。
そう考えると、私のデタラメな英語も、怪しいデータも、「意思を持ったパチンコ玉」も、QSimの豪快な開き直りも、どれもこれも、なんだか、いとおしく思えるようになってきました。
完璧だから好きなのではありません。不完全で、思い通りにならなくて、しょっちゅう裏切られる。それでも捨てずに、疑って、直して、また試して、最後まで付き合う ―― さて、こういう関係を、何と呼べばよいのでしょうか。
つまるところ ――
「研究とは、愛である」
ということなのだと思います。
Copyright © ITmedia, Inc. All Rights Reserved.